LLM به ربات ها کمک می کند تا دستورالعمل های مبهم را درک کنند و روی جزئیات کلیدی تمرکز کنند | اخبار MIT

تصور کنید در آینده ای نزدیک در یک انبار یا اداره کار می کنید و از شما خواسته می شود که به یک کارآموز جدید کمک کنید تا اصول اولیه کار خود را بیاموزد. نکته: این یک ربات است. برای آموزش به آنها، ممکن است بخواهید یک بازی نمایشی انجام دهید و بگویید – یعنی به صورت فیزیکی نشان دهید که چگونه کاری را به چندین روش مختلف انجام دهید و در عین حال توضیح دهید که چه کاری انجام می دهید.
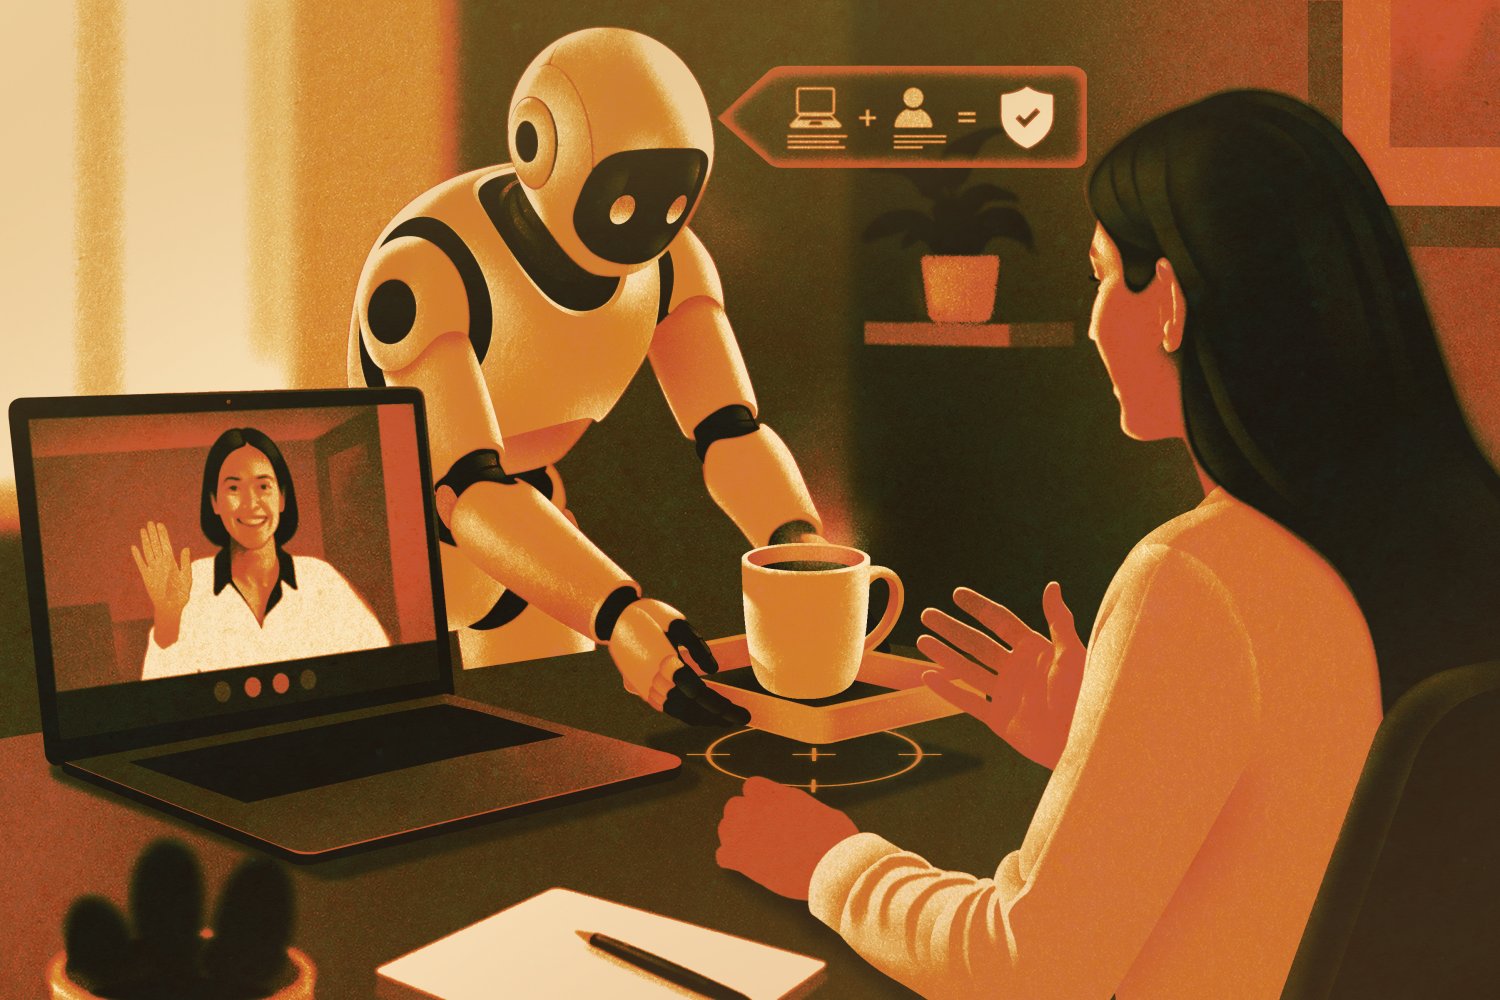
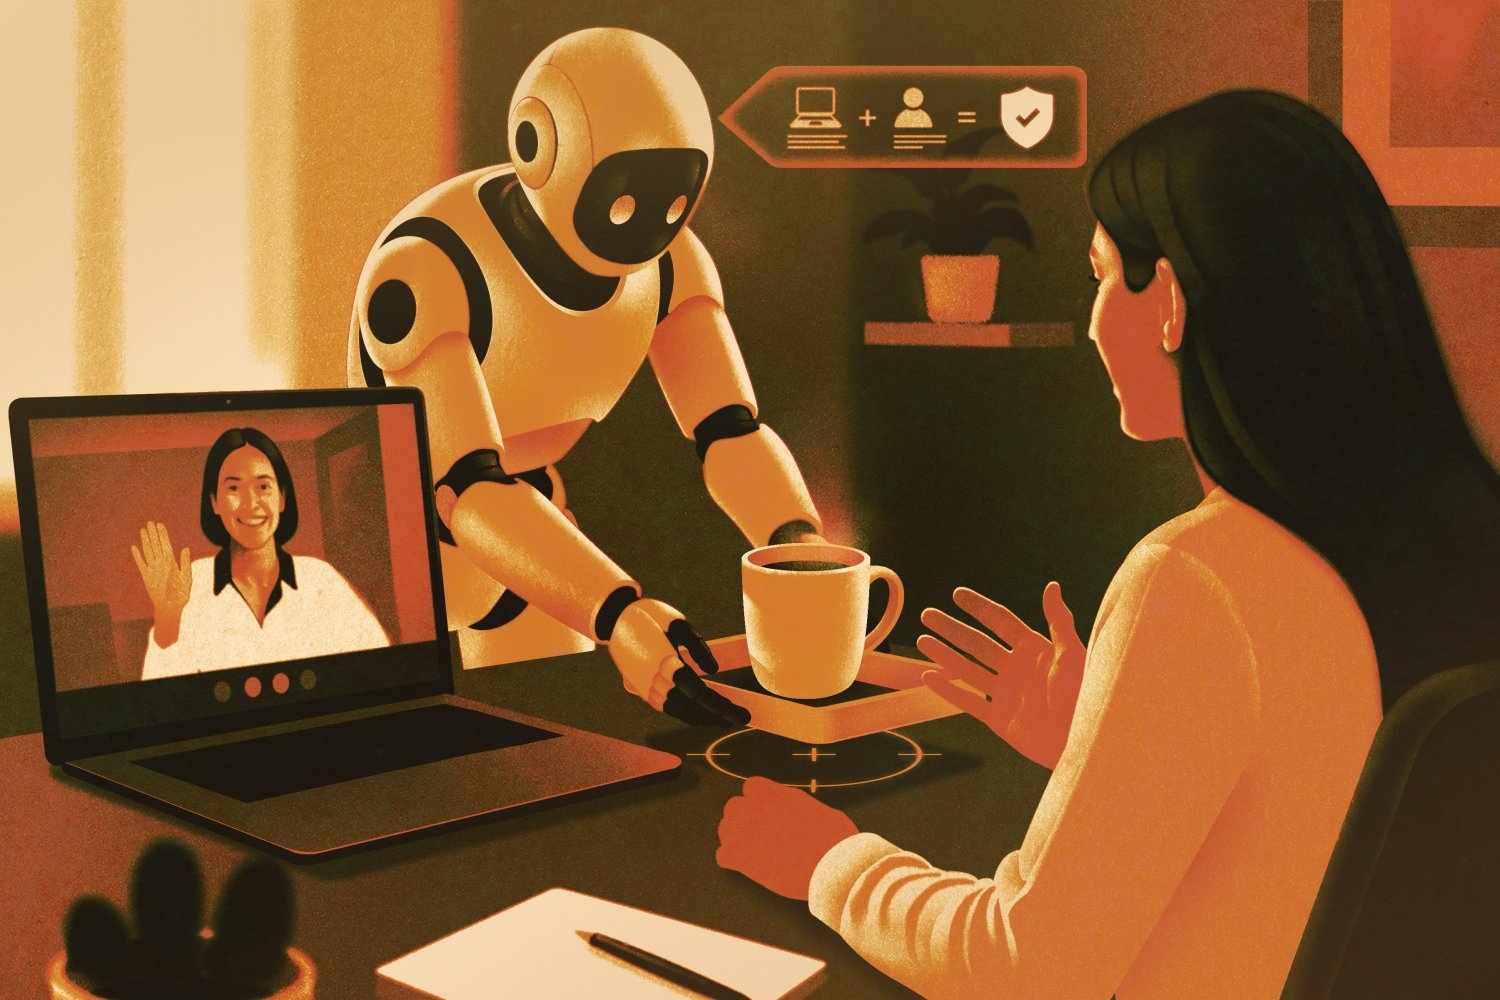
فرض کنید از ربات خواسته اید تا در طول تماس زوم، بدون اینکه مزاحم شما شود، مقداری قهوه روی میز شما بگذارد. شما ترجیح می دهید که ربات خیلی به شما و لپ تاپ نزدیک نشود تا در جلسه شما اختلال ایجاد نکند. برای فعال کردن این رفتار، ربات باید با داده هایی که به وضوح کار کامل را نشان می دهد، آموزش ببیند. دانشمندان کامپیوتر سعی کرده اند وظایف دستکاری ربات را با ثبت بسیاری از نمایش های فیزیکی یا نوشتن دستورالعمل های گسترده توضیح دهند. اما اگر هر دو را نداشته باشید، احتمالاً دستگاه به اشتباه متوجه می شود که چه کاری باید انجام دهد.
انجام این همه نمایش و گفتن برای انسان بسیار پر زحمت است، بنابراین محققان آزمایشگاه علوم کامپیوتر و هوش مصنوعی MIT (CSAIL) با شفاف سازی خودکار دستورالعمل ها و استفاده از داده های نمایشی تقریباً پنج برابر کمتر، فرآیند یادگیری یک ربات را خودکار کردند. رویکرد “آموزش تقویت معکوس Maskid” (Masked IRL) آنها از یک مدل زبان بزرگ (LLM) برای ایجاد اعلانهای مبهم بر اساس دادههای جمعآوریشده از نسخه نمایشی کاربر استفاده میکند. سپس LLM دیگری جزئیاتی را که الگوریتم باید در یک طرح حرکتی گنجانده شود را محدود می کند تا ربات بتواند با خیال راحت وظایف خود را در خانه ها، ادارات و کارخانه ها انجام دهد.
مینیونگ هوانگ، دانشجوی دکترای MIT و محقق CSAIL، که نویسنده اصلی مقاله ای است که این پروژه را ارائه می دهد، گفت: «رویکرد ما زمانی می تواند مفید باشد که یک انسان با یک ربات تعامل داشته باشد اما نمی خواهد تمام جزئیات یک کار را روشن کند. ما تلاش انسان را با اجازه دادن به ماشینها برای دستیابی به آنچه که واقعاً مصرفکنندگان میخواهند به حداقل میرسانیم.»
به گفته هوانگ، Masked IRL میتواند به رباتها کمک کند تا در تنظیماتی که در آن عناصری وجود دارد که ممکن است انسان در یک اعلان توصیف نکند، اما با این وجود حیاتی هستند، مانور دهند. به عنوان مثال، دستگاهی که میان وعده شما را از آشپزخانه می گیرد ممکن است نداند که از برخورد به لپ تاپ شما جلوگیری کند. به همین ترتیب، یک ربات کارخانه ای که اقلام را در جعبه های مختلف قرار می دهد باید با دقت در قفسه ها حرکت کند.
برای یادگیری کارهای جدید در این مواقع، Masked IRL از حسگرهای ربات برای گرفتن اطلاعات پیرامون خود استفاده می کند. این مولفهها همچنین هر حرکت یک نمایش حرکتی را ثبت میکنند – یک رویکرد یادگیری که در آن شخص به صورت فیزیکی یک ربات را برای انجام یک عمل خاص حرکت میدهد. به نوعی مانند فیزیوتراپی دستگاه است که مفاصل را در جهت خاصی خم می کند تا به ربات نشان دهد چگونه اشیا را بگیرد، حرکت دهد و قرار دهد.
سپس سیستم MIT به LLM روی میآورد تا این توالی از حرکات (به نام مسیر) را با کوتاهترین مسیر ممکن مقایسه کند. این مدل همچنین آنچه را که ممکن است در یک اعلان نامشخص باشد، روشن میکند و درخواستی مانند “ایستادن نزدیک” را به “ایستادن نزدیک به سطح میز” تبدیل میکند. با استفاده از مقایسه مسیر و جهتهای روشن، LLM شروع به درک این موضوع میکند که چرا حرکاتی که برای انجام آنها آموزش دیده است برای کار مهم هستند.
سپس LLM دوم جزئیات محیط، مانند موقعیت موانع و شکل جسم مورد نظر ربات را تخمین می زند. در طول این فرآیند، مواردی را که به نظر بی ربط به کار میداند، «ماسک» میکند (به عبارت دیگر، نادیده میگیرد) و هر کدام را بهعنوان «1» (مهم) یا «0» (نه چندان زیاد) میگیرد. به عنوان مثال، اینکه آیا کاربر در حین نمایش آزمایشی به یک میز تکیه داده است یا خیر، “0” خواهد بود که آن را نامربوط می کند. هر جزئیاتی که به عنوان “1” محاسبه می شود در برنامه اقدام نهایی توسط الگوریتم گنجانده شده است.
این ماسکها به Masked IRL یک مزیت کلیدی نسبت به خطوط پایه قابل مقایسه در نمایشهای سه بعدی و واقعی دادند، زیرا به ربات آموزش میدادند کدام اطلاعات را اولویتبندی کند. به لطف سیستم محققان، رباتهای مجازی و واقعی میتوانند به طرز ماهرانهای اجسام را در اطراف موانع مانند جابهجایی یک لیوان قهوه در اطراف لپتاپ به مکانهای مختلف روی میز مانور دهند. در این کارها، Masked IRL به درستی تنظیمات برگزیده کاربر را که به صراحت در درخواستهای خود بیان نکرده بودند، تا 15 درصد بیشتر از خطوط پایه قابل مقایسه شناسایی کرد.
در طول آزمایش های شبیه سازی، محققان CSAIL همچنین دریافتند که Masked IRL به سرعت یاد می گیرد. برای درک نحوه جابجایی فنجان از خطوط پایه به دموهای کمتری نیاز بود. آنها همچنین دریافتند زمانی که LLM به جای اینکه ماشین سعی کند از یک درخواست مبهم پیروی کند، دستورالعمل ها را پاک کرد، ربات ها عملکرد بهتری داشتند.
این رویکرد متمرکزتر همچنین به خوبی به بازوی روباتیک واقعی تبدیل شد که دستوراتی را که سیستم در مرحله آموزش ندیده بود انجام می داد. ربات پس از آموزش روی 50 نمایش حرکتی، با دقت یک فنجان را به سمت یک فرد حرکت داد و در عین حال از برخورد با رایانه کاربر اجتناب کرد – مانعی که با ایجاد یک درخواست کلی تر برای “دور ماندن” یاد گرفت که از آن اجتناب کند. همچنین یک میز را در حالی که “نزدیک” آن می ایستد پاک می کند و در حالی که “دور ایستاده” از یک شخص و هم از یک میز به کاربر یک کیسه چیپس می دهد.
IRL Masked آنچه را که کاربران ناگفته می گذارند را حس می کند و توضیح می دهد، اما ممکن است به زودی آن را نیز “ببینند”. محققان CSAIL قصد دارند با تجهیز آن به دوربین هایی که به ربات اجازه می دهد از محیط اطراف خود عکس بگیرد، رویکرد خود را پویاتر کنند. سپس می تواند موارد خاصی را در نزدیکی خود برجسته کرده و بر روی آنها تمرکز کند. برای مثال، اگر از دستگاه بخواهید اسباببازی را بردارد، ممکن است چند موز در نزدیکی آن ببیند و قبل از برخورد با شی مورد نظر، آنها را نادیده بگیرد.
هوانگ مقاله را با سه همکار CSAIL نوشت: دانشجوی دکتری الکساندرا فورسی-اسمرک ’20، SM ’22; پسادکتر ناتانیل دنلر؛ و استادیار آندریا بوبو از MIT که عضو دپارتمان هوانوردی و فضانوردی و CSAIL است. کار آنها تا حدی توسط گروه تاتا از طریق جایزه کنسرسیوم تأثیر هوش مصنوعی MIT و وزارت دفاع حمایت شد. آنها این پروژه را در کنفرانس بین المللی IEEE 2026 در مورد رباتیک و اتوماسیون در ژوئن ارائه خواهند کرد.